顯示具有 Performance 標籤的文章。 顯示所有文章

2024年2月13日 星期二

SQL Server 載入防毒軟體模組的處理

        防毒軟體相信在很多的主機上都會安裝,在 SQL Server 上也是不例外,但因為防毒軟體造成的影響,在真的遇到時,如果發現兇手是防毒時,真的會爆火氣,但在沒有相對的證據指出是防毒造成的影響時,真的很難說服客戶進行移除。 

 另一方面,就算客戶暫時停用防毒程式,但這樣就真的沒有影響了嗎?其實答案為 "否",因為已載入至執行的程式中,就算你把主程式停用,但已載入的部份,還是有很大的影響,所以通常要說服客戶進行移除防毒。 一般在證據的收集上,如果是服務無法啟動,我們就透過微軟的一個內部人幾乎都要會的軟體 Process Monitor 進行收集,藉以找出是否是被其他的程式所影響,這也是一個我們主要找出的方法之一。

近日,遇到一個效能的案件,透過先前介紹的工具完整的收集客戶問題發生的區間,其中就發現 SQL Server 竟然載入了 TrendMicro 的 perfiCrcPerfMonMgr.dll 模組,進一步的確認的確是趨視 (TrendMicro) 的防毒軟體,如下所示。


DMV - -- sys.dm_os_loaded_modules --
C:\Program Files (x86)\Trend Micro\OfficeScan Client\perfiCrcPerfMonMgr.dll 

後來在想為何這個模組會載入至 SQL Server,而且進一步的查詢,發現這個載入其實代表安裝防毒軟體時,沒有設定排除 SQL Server,其實常見許多的客戶也是沒有進行這個設定,一但沒有設定,後續可能會造成效能問或相關檔案的毀損,所以最後的方法,就是要設定下列的作法即可,設定後,一來不會將相關的模組植入至 SQL Server 的執行中,也可以避免防毒軟體掃描造成相關的 mdf, ldf 的檔案毀損。

相關參考:

建議設定與解決方法:

最後建議,除了可以透過上述的 DMV 進行收集之外,也可以透過上面介紹的 LogScout 或 PSSDiag 統一收集後,也可以透過 SQL Nexus 進行分析,找出此問題,所以再次強烈的推薦給大家。


2024年1月31日 星期三

SQL Server CPU 在 NUMA 節點上,CPU 負載不平衡的處理

最近接到客戶反應,為何 SQL Server 的主機上的 CPU 的負載只有在其中的一個 NUMA 的節點上,所以想請我們協助判斷是否為何有這種情況,如下列的例圖。

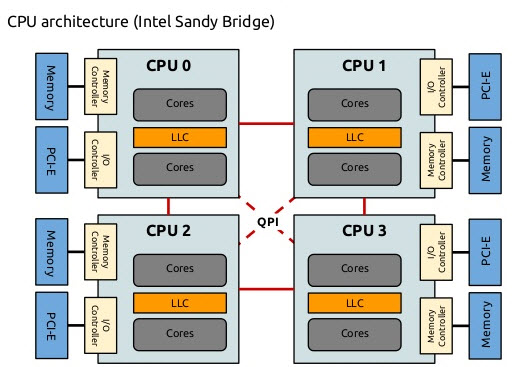
在說明如何排查問題時,我們先來介紹一下何為 NUMA 節點,NUMA 全名為 "Non-uniform Memory Access",主要用於加速 CPU 與 Memory 的效能存取,簡單的說,在 CPU 上會放在一個 CPU socket 的插座上,假設底層有 Dual Processor,就代表有二顆 CPU 與二個 CPU 插座,而在 SQL Server 中就會有二個 NUMA 節點,如下圖所示。


進一步的驗證,可以透過系統資訊(MSINFO)與 SQL Server 中的 Error Log 中進行確認。

系統資訊:

Processor(s):              2 Processor(s) Installed.

[01]: Intel64 Family 6 Model 63 Stepping 2 GenuineIntel ~2594 Mhz

[02]: Intel64 Family 6 Model 63 Stepping 2 GenuineIntel ~2594 Mhz


SQL Server Error Log

2024-01-20 21:29:02.16 Server      Node configuration: node 0: CPU mask: 0x0000000000000fff:0 Active CPU mask: 0x0000000000000fff:0. This message provides a description of the NUMA configuration for this computer. This is an informational message only. No user action is required.

2024-01-20 21:29:02.16 Server      Node configuration: node 1: CPU mask: 0x0000000000fff000:0 Active CPU mask: 0x0000000000fff000:0. This message provides a description of the NUMA configuration for this computer. This is an informational message only. No user action is required.

2024-01-06 19:39:03.14 Server      SQL Server detected 2 sockets with 12 cores per socket and 12 logical processors per socket, 24 total logical processors; using 24 logical processors based on SQL Server licensing. This is an informational message; no user action is required.

如上述的資訊,有二個 CPU 插座 (socket),12 核心,24個邏輯核心,所以在 SQL Server 會識別為 2個 NUMA 節點,每個節點有12個核心,總共有 24 個核心可用。

簡單的說,透過 NUMA 節點,彼此間有各自的通道與 IO,記憶體等進行溝通,將有助於流量的隔離與區分,有助於減少彼此間的影響,架構上如下圖所示。

問題排除建議:

1. 首先需要確認此主機是否有其他的程式影響造成 CPU 不平衡的情況發生,或許兇手不完全是 SQL Server,簡單的方式,可以透過工作管理員 (Task Manager),但如果要長期監控,可以透過效能監視器中的 Processor Time 來判斷是否真的就是 SQL Server 所造成。

由上圖的監控上來看,可以知道幾乎就是 SQL Server 的程式所造成的。

2. 由於 SQL Server 上的 NUMA 節點預設是自動設定,強烈的建議千萬不要自已去異動,千萬不用動設定,千萬不用動設定,千萬不用動設定,很重要,所以說三次,我將相關的設定整理如下。


max degree of parallelism -> 1

Resource_governor_configuration = 0 

affinity mask -> 0

affinity I/O mask -> 0

affinity64 mask -> 0

affinity64 I/O mask -> 0


3. 透過 DMV 查詢是否有系統有修改過 Soft NUMA 的設定,下列的值為 0,所以代表也是沒有修改過。

select softnuma_configuration,* from sys.dm_os_sys_info

參考連結:
https://learn.microsoft.com/zh-tw/sql/database-engine/configure-windows/soft-numa-sql-server?view=sql-server-ver16


4. 預設的情況下,SQL Server 在工作的分配上,都是透過輪詢 (Round-Robin) 的方式進行分派,所以如果上一步沒有進行手動配置就要進一步的看 SQL Server 分配的情況,我們可以透過下列的二個 DMV 來進行查詢。

4-1 確認目前各 NUMA 節點的連線數配置。

select node_affinity,count(*) num from sys.dm_exec_connections
group by node_affinity


4-2 確認在排程上,load_factor 的值是否有異動,通常如果有排程的話,此值會因為排序的關係 值會減少,所以你可以持續查詢確認此值會不斷的變化。

select load_factor, * from sys.dm_os_schedulers

where status = 'VISIBLE ONLINE'

4-3 透過 4-1 的值可以看到,二個節點在分配的數量上,會差一點,這是因為連線時的工作可能有很快就執行完,有的要執行很久,所以基於上述的確認,可以看到還是有輪詢分派,另外平行處理的部份,也可能會影響單邊跑的情況過久,進一步的資訊,也可以透過下列的查詢,看有那些連線執行過久。


select node_affinity,* from sys.dm_exec_connections


4-4 如果需要查詢 Session ID 執行的語法為何,也可以透過下列的語法進行查詢。


select wait_type, * from sys.dm_exec_requests

where session_id > 50


5. 透過上述的方式,可以確認分配的情況,但另一方面,也有可能因為效能問題造成壓力集中在 NUMA 節點 0上,此部份可以參考我的另一篇文章進行收集與確認。

如何進行 SQL Server 效能資料收集與分析 - 以 LogScout, PSSDiag, SQL Nexus 工具為例https://caryhsu.blogspot.com/2023/12/sql-server-logscout-pssdiag-sql-nexus.html
How It Works: Soft NUMA, I/O Completion Thread, Lazy Writer Workers and Memory Nodes
https://techcommunity.microsoft.com/t5/sql-server-support-blog/how-it-works-soft-numa-i-o-completion-thread-lazy-writer-workers/ba-p/316044


經過上述的檢查,最後確認客戶的問題主要在於效能問題上,所以進一步的透過 LogScount 收集並再分析提供給客戶,但基於上述的資訊,可以完整的證明分配的情況,當然如果真的有調整過 Affinity 的相關設定值,也確認一下是否真的有調整的需要,或是也可以開案件給 Microsoft Support 進行討論與確認。

2023年11月10日 星期五

如何透過 Partition Table 進行資料分散與維護作業並以年度為例

        先前一篇針對 Partition Table 進行詳細的介紹,近日再重新的檢示,其實我覺得自已當初提出的資料平均分配的方式很好,而且其實到現在還是很適用,但由於有很多的客戶需求,希望可以透過日期的方式來進行資料分散與切割,所以今天我就透過這篇來特別介紹一下。

如何在 AlwaysOn 建立 Partition Table 與自動進行資料平均分配http://caryhsu.blogspot.com/2016/01/alwaysonpartition-table.html

此篇我們透過 AdventureWorks 的資料庫來進行,並且也會說明在建立後,如果遇到新年度時,大佬與預算較緊的使用者們,針對透過年月的方式進行資料分散的方式,該如何維護,這篇也會詳細的介紹。

本篇在 Partition Table 建立後,其實維護是最麻煩的,由其在 Merge 與 Split 的部份,我其實也是在測試機上測試了好多次,才摸清最好與最佳的方式,希望二篇加起來後,可以更完整的幫助到大家。

1。 加入 file group 與 files,這邊建議將 file 分散至不同的卷上面,最好的情況是有四台實體磁碟,各自放一個 file。

USE [master]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILEGROUP [ag_group_1]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILEGROUP [ag_group_2]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILEGROUP [ag_group_3]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILEGROUP [ag_group_4]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILE ( NAME = N'fg_1', FILENAME = N'C:\sql_data\fg_1.ndf' , SIZE = 51200KB , FILEGROWTH = 1024KB ) TO FILEGROUP [ag_group_1]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILE ( NAME = N'fg_2', FILENAME = N'C:\sql_data\fg_2.ndf' , SIZE = 51200KB , FILEGROWTH = 1024KB ) TO FILEGROUP [ag_group_2]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILE ( NAME = N'fg_3', FILENAME = N'C:\sql_data\fg_3.ndf' , SIZE = 51200KB , FILEGROWTH = 1024KB ) TO FILEGROUP [ag_group_3]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILE ( NAME = N'fg_4', FILENAME = N'C:\sql_data\fg_4.ndf' , SIZE = 51200KB , FILEGROWTH = 1024KB ) TO FILEGROUP [ag_group_4]
GO

2. 由於目前有四個資料群組,所以我們先統計一下資料量,然後再來規畫一下如何分散資料,目前如下圖,主要有2013年7月至2014年8月的資料。

--統計資料分佈

SELECT left(convert(varchar,TransactionDate,112),6) [tdhyear], count(*) nums
FROM [AdventureWorks2019].[Production].[TransactionHistory]
group by  left(convert(varchar,TransactionDate,112),6)
order by 1,2


3. 建立 Partition Function 與 Partition Schema,這邊會建立三個區域與對應至四個 File Group,如下列所示。

1900-01-01 00:00:00.000 ~ 2013-10-01 00:00:00.000 -> 儲存至 ag-group_1
2013-10-01 00:00:00.000 ~ 2014-02-01 00:00:00.000 -> 儲存至 ag-group_2
2014-02-01 00:00:00.000 ~ 2014-04-01 00:00:00.000 -> 儲存至 ag-group_3
2014-04-01 00:00:00.000 ~ 日後所有 -> 儲存至 ag-group_4

--將資料平均分散在多個不同區間

use [AdventureWorks2019];
CREATE PARTITION FUNCTION [PF-cary-test](datetime) AS RANGE RIGHT FOR VALUES (N'2013-10-01T00:00:00', N'2014-02-01T00:00:00', N'2014-04-01T00:00:00')

PS: 這裡建議採用 RANGE RIGHT 的方式,而不是用 RANGE Left, 因為我在 SQL Server 2019 與 2022 上測試,當使用 RANGE Left 的方式時,如果進行 SPLIT RANGE時,你會發現 ALTER PARTITION SCHEME 中的 NEXT USED 當合併資料,並將新加入的 file 與前一個 file 互換,雖然這樣也是沒問題,但還是覺得怪怪的,所以這邊也再請注意一下。

CREATE PARTITION SCHEME [PS-cary-test] AS PARTITION [PF-cary-test] TO ([ag_group_1], [ag_group_2], [ag_group_3], [ag_group_4])

4. 建立完上述的動作後,資料並不會立即的進行資料的搬移,需透過移除 Clustered Index 後,再將索引重新加入後即可

此處原本 TransactionID 是 PK 與 CLUSTERED INDEX,但由於此處的 Partition Table 是根據 TransactionDate 進行分配,所以要將 CLUSTERED INDEX 換成 TransactionDate 之後,資料才會重新進行排序。

ALTER TABLE [Production].[TransactionHistory] DROP CONSTRAINT [PK_TransactionHistory_TransactionID] WITH ( ONLINE = OFF )

ALTER TABLE [Production].[TransactionHistory] ADD  CONSTRAINT [PK_TransactionHistory_TransactionID] PRIMARY KEY NONCLUSTERED
(

[TransactionID] ASC

)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, SORT_IN_TEMPDB = OFF, IGNORE_DUP_KEY = OFF, ONLINE = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON, OPTIMIZE_FOR_SEQUENTIAL_KEY = OFF) ON [PRIMARY]

CREATE CLUSTERED INDEX [ClusteredIndex_on_PS-cary-test_638351445508081513] ON [Production].[TransactionHistory]
(

[TransactionDate]

)WITH (SORT_IN_TEMPDB = OFF, DROP_EXISTING = OFF, ONLINE = OFF) ON [PS-cary-test]([TransactionDate])

DROP INDEX [ClusteredIndex_on_PS-cary-test_638351445508081513] ON [Production].[TransactionHistory]

5. 透過下列的語法進行查詢,並確認資料在各群組分配的情況

SELECT OBJECT_NAME(p.object_id) AS ObjectName ,
i.name AS IndexName ,p.index_id AS IndexID ,
ds.name AS PartitionScheme ,
p.partition_number AS PartitionNumber ,
fg.name AS FileGroupName ,
prv_left.value AS LowerBoundaryValue ,
prv_right.value AS UpperBoundaryValue ,
CASE pf.boundary_value_on_right
WHEN 1 THEN 'RIGHT'
ELSE 'LEFT'
END AS PartitionFunctionRange ,
p.rows AS Rows
FROM sys.partitions AS p
INNER JOIN sys.indexes AS i ON i.object_id = p.object_id
AND i.index_id = p.index_id
INNER JOIN sys.data_spaces AS ds ON ds.data_space_id = i.data_space_id
INNER JOIN sys.partition_schemes AS ps ON ps.data_space_id = ds.data_space_id
INNER JOIN sys.partition_functions AS pf ON pf.function_id = ps.function_id
INNER JOIN sys.destination_data_spaces AS dds ON dds.partition_scheme_id = ps.data_space_id
AND dds.destination_id = p.partition_number
INNER JOIN sys.filegroups AS fg ON fg.data_space_id = dds.data_space_id
LEFT OUTER JOIN sys.partition_range_values AS prv_left ON ps.function_id = prv_left.function_id AND prv_left.boundary_id = p.partition_number- 1
LEFT OUTER JOIN sys.partition_range_values AS prv_right ON ps.function_id = prv_right.function_id AND prv_right.boundary_id = p.partition_number
WHERE p.object_id = OBJECT_ID('Production.TransactionHistory');


6。 從查詢上來看,後續未規畫的資料年度就會放置到最後一個 file group,所以當新年度到達時,通常我們會採取二種不同的作法,一時加入一個 file group,然後將後續的資料加入,另一種就是合併資料,並將新年度的資料轉向最後一個 file group中,所以也在這分別說明二種方式。

7。 課長級作法。也就是加入一個 file 並將新年度的資料轉至此新的 file 中

7-1. 加入新的 file group

use [master];
ALTER DATABASE [AdventureWorks2019] ADD FILEGROUP [ag_group_5]
GO

ALTER DATABASE [AdventureWorks2019] ADD FILE ( NAME = N'fg_5', FILENAME = N'C:\sql_data\fg_5.ndf' , SIZE = 51200KB , FILEGROWTH = 1024KB ) TO FILEGROUP [ag_group_5]
GO

7.2 將新的 file group 加入至 schema 中,並分割出新的資料區間時區,就是將 '2015-01-01' 後的時間,儲存至新的 file 中

use [AdventureWorks2019];
ALTER PARTITION SCHEME [PS-cary-test]
NEXT USED ag_group_5;

ALTER PARTITION FUNCTION  [PF-cary-test] () 
SPLIT RANGE ('2015-01-01T00:00:00.000')

7-3 查詢資料分佈的情況

8. 微課長級的作法,如果無法增加新的 file 用來分散資料的話,可以透過資料合併的方式,然後將新的資料儲存至最後一個群組中

8-1 依照資料上的分佈,我先將 file 3 與 4 的資料先進行合併,所以這邊我將 2014-02-01 00:00:00.000 之後的資料先合併至 ag-group3

ALTER PARTITION FUNCTION [PF-cary-test] () 
MERGE RANGE ('2014-04-01 00:00:00.000');

8-2 將 2015-01-01 之後的資料存到 ag-group4 上面

ALTER PARTITION SCHEME [PS-cary-test]
NEXT USED ag_group_4;

ALTER PARTITION FUNCTION  [PF-cary-test] () 
SPLIT RANGE ('2015-01-01T00:00:00.000'); 

8-3 由於有作過資料合併的動作,所以最好也是手動更新一次統計資訊

UPDATE STATISTICS [Production].[TransactionHistory]

8-4 查詢資料分佈的情況

2023年11月6日 星期一

啟用即時初始化檔案 (Instant file initialization) 的功能於 SQL Server 上

        即時初始化檔案 (Instant file initialization) 其實在 SQL Server 2005 就有提出,但隨著 SQL Server 版本的更新,此功能也不斷的更新與強化,所以此篇也特別介紹一下這個功能。

即時初始化檔案 (Instant file initialization) 主要說穿了,就是在建立資料庫 (Database) ,擴展空間或是還原資料庫等動作時,不進行磁碟初始化寫 zero 0 的動作,藉以加快初始化的動作,這樣一來在要求空間等動作時,可以加快申請的初始化動作,而且在 資料頁面(Data File) 的空間要求越大時,效果更是明顯,因為可以略過初始化填寫 zero 0 的動作。

通常有利也是有弊,我們在啟用這個功能時,也在深入的探討這個功能是否真的這麼強悍,但是否真的有適合不同的資料庫環境,我們分成下列的幾個方向進行討論。

1. 啟用此功能後是否會造成資料的錯寫或是錯亂等問題。

此功能持續觀察與使用已久,坦白說沒有遇過客戶回饋等問題,而且在相關的修正上,也沒有發現,所以這部份我覺得不是主要的問題。

2. 啟用後對效能上的影響,大約會有多少,是否有其他的負面影嚮。

此功能在啟用後,主要是進行相關動作時,不會針對 資料頁面(Data Page) 進行初始化寫 0 的動作,所以可以大大的加速擴展空間、建立資料庫、還原資料庫等動作,但是在負面影嚮的部份,我覺得主要是在安全性的部份,由於資料頁面沒有進一步的初始化,所以當有人透過此磁碟進行資料還原等動作時,是有可能可以查到之磁碟上原先存放的資料為何,這在有些管理上,可能是不允許的,也是有一定的風險存在的。

此功能在支援上,地端與雲端會有不同的支援程度,在雲端上,部份是沒有支援的,如 Azure 原本也是沒有支援的,但後來在 transaction log 的部份,是有 "部份" 支援的,但相對的 資料頁面(Data Page) 的部份,也是沒有支援的。

Database instant file initialization
Database instant file initialization - SQL Server | Microsoft Learn

另外在 AWS 上,很多人會透過 Amazon FSx for Windows File Server 來當作 SQL Disk 的部份,這部份也是沒有支援的,因為這個以前也有遇過客戶來討論過效能的問題,後來發現是不支援此功能,所以印像特別的深刻。

Using FSx for Windows File Server with Microsoft SQL Server
Using FSx for Windows File Server with Microsoft SQL Server - Amazon FSx for Windows File Server

說了這麼多,我們就來開始介紹如何進行啟用的方式。

在啟用的部份,你可以在一開始安裝時,在 Server Configuration 的部份,勾選 "Grant Perform Volme Maintenance Task privilege to SQL Server Database Engine Service" 的選項。


或是安裝完成後,從 SQL Server Configuration Manager -> SQL Server Service -> SQL Server(Instance name) -> Properties -> Advanced -> Instant File Initialization


另外在啟用時也請確認在作業系統層級,是否有權限進行套用,從 Local Security Policy -> Local Policies -> User Rights Assignment -> Perform volume maintenance tasks,請將你的 SQL Server 的啟動帳號加入此區的設定中即可。


設定完成後,你可以透過二個方式確認 SQL Server 是否有套用到 Instant file initialization 的功能。

1. 透過 SQL Server 的 Error Log 確認啟動時是否有套用此功能。

2023-11-03 18:02:37.12 Server      Database Instant File Initialization: enabled. For security and performance considerations see the topic 'Database Instant File Initialization' in SQL Server Books Online. This is an informational message only. No user action is required.

2. 透過 T-SQL 指令查詢是否有啟用 Instant file initialization。

select servicename, status_desc, service_account, instant_file_initialization_enabled from sys.dm_server_services


一切準備就緒就後,我們可以來透過建立資料庫的方式,來比較二者間的差異,藉以了解在啟用後之間的差異。

--啟用 Trace Flag 將建立資料庫等資訊寫入至 SQL LOG 中。
DBCC TRACEON(3004 ,3605 ,-1);
GO

CREATE DATABASE [testIFI]
 CONTAINMENT = NONE
 ON  PRIMARY 
( NAME = N'testIFI', 
  FILENAME = N'C:\tmp\testIFI.mdf' , 
  SIZE = 40GB)
 LOG ON 
( NAME = N'testIFI_log', 
  FILENAME = N'C:\tmp\testIFI_log.ldf' , 
  SIZE = 20GB)
GO


輸出比對:
2023-11-03 17:52:14.76 Server      Database Instant File Initialization: disabled.
2023-11-03 17:54:39.78 spid64      Zeroing C:\tmp\testIFI.mdf from page 0 to 5242880 (0x0 to 0xa00000000)
2023-11-03 17:54:44.13 spid64      Zeroing completed on C:\tmp\testIFI.mdf (elapsed = 4347 ms)
2023-11-03 17:55:33.57 spid64      Zeroing C:\tmp\testIFI_log.ldf from page 0 to 2621440 (0x0 to 0x500000000)
2023-11-03 17:56:25.14 spid64      Zeroing completed on C:\tmp\testIFI_log.ldf (elapsed = 51562 ms)
2023-11-03 17:56:25.23 spid64      Starting up database 'testIFI'.
2023-11-03 17:56:25.26 spid64      Parallel redo is started for database 'testIFI' with worker pool size [1].
2023-11-03 17:56:25.26 spid64      FixupLogTail(progress) zeroing 2 from 0x5000 to 0x6000.
2023-11-03 17:56:25.26 spid64      Zeroing C:\tmp\testIFI_log.ldf from page 3 to 483 (0x6000 to 0x3c6000)
2023-11-03 17:56:25.27 spid64      Zeroing completed on C:\tmp\testIFI_log.ldf (elapsed = 7 ms)
2023-11-03 17:56:25.28 spid64      Parallel redo is shutdown for database 'testIFI' with worker pool size [1].

2023-11-03 18:02:37.12 Server      Database Instant File Initialization: enabled. For security and performance considerations see the topic 'Database Instant File Initialization' in SQL Server Books Online. This is an informational message only. No user action is required.
2023-11-03 18:04:43.74 spid63      Zeroing C:\tmp\testIFI2_log.ldf from page 0 to 2621440 (0x0 to 0x500000000)
2023-11-03 18:06:14.82 spid63      Zeroing completed on C:\tmp\testIFI2_log.ldf (elapsed = 91083 ms)
2023-11-03 18:06:14.90 spid63      Starting up database 'testIFI2'.
2023-11-03 18:06:14.94 spid63      Parallel redo is started for database 'testIFI2' with worker pool size [1].
2023-11-03 18:06:14.94 spid63      FixupLogTail(progress) zeroing 2 from 0x5000 to 0x6000.
2023-11-03 18:06:14.94 spid63      Zeroing C:\tmp\testIFI2_log.ldf from page 3 to 483 (0x6000 to 0x3c6000)
2023-11-03 18:06:14.95 spid63      Zeroing completed on C:\tmp\testIFI2_log.ldf (elapsed = 8 ms)
2023-11-03 18:06:14.96 spid63      Parallel redo is shutdown for database 'testIFI2' with worker pool size [1].

從上述的結果,你就可以看到,當 Instant File Initialization 啟用時,資料頁面 (Data Page) 是完全不作初始化的動作 (zero),如同上述的說明,最後仍提醒在啟用此功能其實是真的可以大幅減少相關擴展的動作,但其相對的安全性,只能說可能要依不同的行業別在進行評估,如金融業等,當然存放資料的不同,可能也是要考慮,最後也希望此篇可以幫助到大家。

2015年7月3日 星期五

使用SQL Nexus進行SQL Server完整效能資訊收集與分析

        所謂工欲善其事、必先利其器,當系統發生問題時,如何完整的收集系統問題,並且可以將資料提供給其他的專家進行分析,其實當微軟的SQL Server專家在進行資訊收集時也會透過此工具進行,並進行分析,所以 "非常強烈" 的建議大家使用此工具進行,一來可以盡可能的收集完整的資訊於問題發生的過程中,二來又可以進行自動分析,而且此軟體完全免費,所以此篇我們就來詳細的介紹如何進行。

工具下載:
SQL Nexus Tool
http://sqlnexus.codeplex.com/releases/view/119562

下載後,你會發現有二個主要的資料夾,分別是 DataCollectors 與 SqlNexus4.0.0.64兩個資料夾,DataCollectors主要進行收集,而SqlNexus則是進行資料分析用,首先我們就先進行資料收集的動作。

收集主機資訊:
主機名稱:SQL2012-MAIN
版本:SQL Server 2012
是否為Cluster:否

資料收集:
在DataCollectors目錄中有從SQL 2005 ~ 2014中各個版本的收集腳本,由於我們目前要收集的版本為SQL Server 2012,所以我們先將DataCollectors目錄中的PerfStatsScript2012.zip的壓縮檔解壓縮並放置到SQL Server主機上,然後開啟一個DOS視窗後, 輸入 "StartSQLDiagTrace2012.cmd" 後即可進行收集,如下圖所示。

重點提示:
1、路徑中不要包含有中文名稱。
2、路徑最好不要過長。
3、收集的過程中會稍為的影響系統的運作,可能約5~10%左右,所以進行時請特別注意。
4、收集時最好在問題發生的區段間進行,且最好收集30分鐘。
5、收集完成後,會將檔案輸出在相同目錄中名為 "SQLDiagOutput" 的資料夾。
6、如果要進行結束時,請直接按Ctrl + C即可進行結束。


資料分析:
在使用SQLNexus的程式進行分析前,請先安裝並確認下列的項目是否符合。

先行需求項目:
1、.NET framework 4.0 is required.
2、If you are on SQL 2008 or 2008 R2, you must install report viewer control 2010. If you are on SQL Server 2012, you can skip this step
3、You must install a ReportViewer.exe hotfix. Otherwise, drill-through link won't work.
4、You must install RML Utilities.

接下來我們要將收集到的資料匯入到資料庫後,並透過SQL Nexus進行分析,首先我們先進入SqlNexus的目錄中,然後請一定要以 "Run as Administrator" 的方式啟動sqlnexus.exe的程式。

啟動程式後,需選擇你的資料要匯入到那一台的資料庫上,匯入的資料庫與收集的資料庫可以是不同台。

如果你遇到下列的錯誤訊息時,代表你沒有安裝RML Utilities.的套件,請再執行一次並重啟程式。

錯誤訊息:
[sqlnexus.fmNexus.fmNexus.Load] Unable to locate readtrace. Nexus wan't be able to load or analyze profiler trace data.


程式啟動後,請選選擇右上角要匯入的資料庫名稱,預設為 "sqlnexus" ,由於匯入後會進行覆寫,所以請選擇一個資料庫進行匯入,然後再選擇 "Import" 進行匯入。


匯入完成後即會如同下列的畫面。

匯入後,請選擇左上角的 "SQL Perf Main" ,即可發現此工具已完成資料剖析的動作,接下來我們來逐一看看所有的功能。

第一個 "ReadTrace Reports" 此報表會顯示收集的區間中SQL語法執行的活動量。


再點選 "Unique Batches" 後,你可以看到主要有四個區塊,分別是CPU、執行時間、讀取、寫入的統計,而下方也可以看到分別是排行的SQL語法。

Blocking and Resource Wait Statistics的分析。

SQL Server瓶頸分析

其中我覺得非常好用的是此程式可以幫你找出Missing Indexes的部份,並且直接的幫你產生語法,你只需要將語法貼到SQL Server上,即可立即產生相對應的語法。

最後在匯入的過程中可能會有某個檔案造成匯入失敗,你可以將此檔案先行移走,即可匯入完成,此時這個檔案你就必須透過人工的方式進行分析,我將重要的檔案說明整理如下,再請參考。

檔案介紹:
1、SQL Server Log、系統資訊、效能收集
xxx__sp_sqldiag_Shutdown.OUT
xxx__SQL_2012_Perf_Stats_Snapshot_Shutdown.OUT
xxx__SQL_2012_Perf_Stats_Snapshot_Startup.OUT
xxx__SQL_2012_Perf_Stats_Startup.OUT

2、事件檢示記錄
xxx_application_Shutdown.CSV
xxx_security_Shutdown.CSV
xxx_system_Shutdown.CSV

3、SQL語法收集
xxx_SQLDIAG__sp_trace.trc
xxx_SQLDIAG__sp_trace_blk.trc

4、OS系統效能收集
SQLDIAG.BLG

5、程式收集過程記錄
Internal -> ##console.log  

上述中xxx代表你的主機名稱

關鍵字:SQL Server、SQL Nexus、Data Collector、Performance Tuning